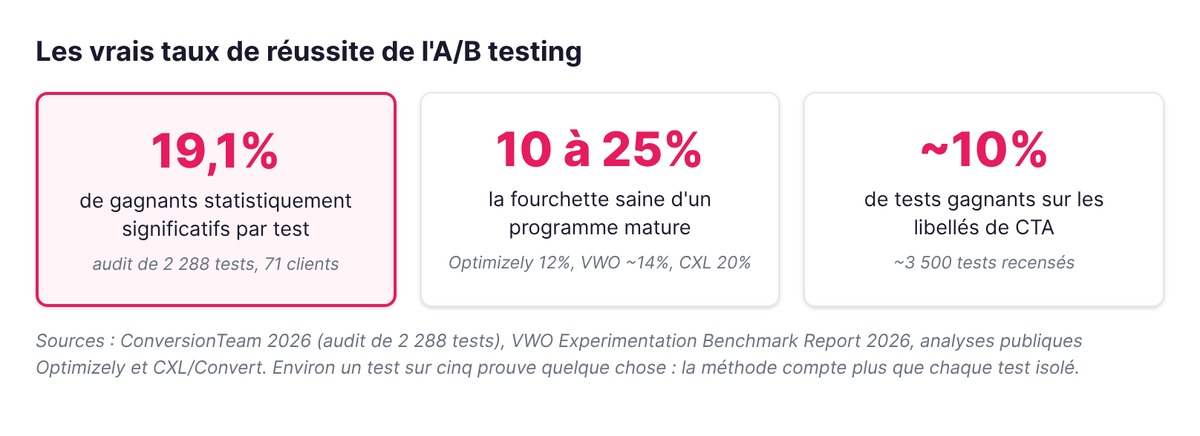
L'A/B testing consiste à exposer deux versions d'une page à deux moitiés de votre trafic, réparties aléatoirement, pour mesurer laquelle convertit le mieux avec un seuil de confiance statistique (95% en standard). Dans les programmes matures, 10 à 25% des tests produisent un gagnant statistiquement significatif : Optimizely rapporte 12%, VWO environ 14%, CXL 20%, et un audit de 2 288 tests publié par ConversionTeam aboutit à 19,1% (source : ConversionTeam, 2026). Environ un test sur cinq prouve quelque chose. L'A/B testing est donc un jeu d'itération : la méthode compte plus que chaque test pris isolément. Ce guide détaille cette méthode en 7 étapes, chiffre le trafic nécessaire (rarement fait en français), et vous dit quoi faire si votre site n'a pas ce trafic, le cas de la majorité des PME.
Qu'est-ce que l'A/B testing ?
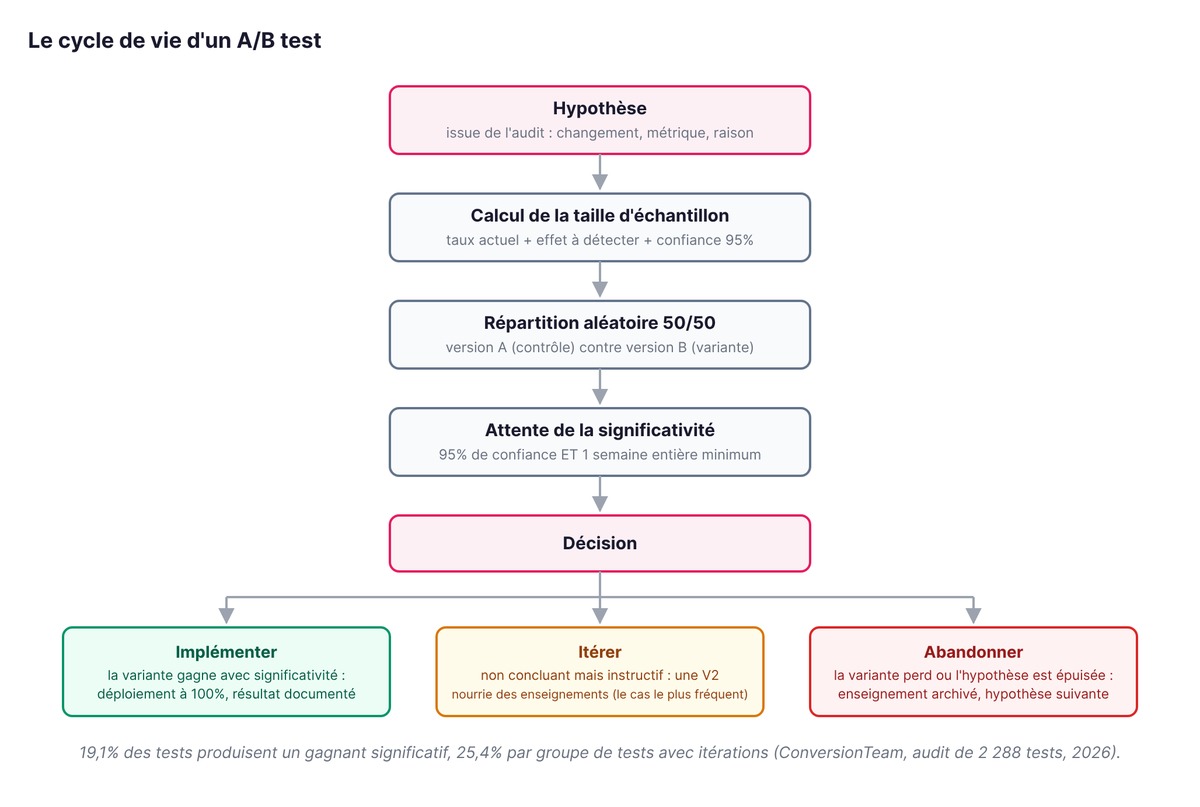
Un A/B test compare deux versions d'une même page : la version A (le contrôle, votre page actuelle) et la version B (la variante, qui modifie un élément précis). Votre outil de test répartit les visiteurs aléatoirement entre les deux, en général 50/50, et mesure quelle version génère le plus de conversions. Si la différence observée dépasse le seuil de confiance fixé (95% en standard), vous avez un gagnant prouvé. Sinon, vous avez un résultat non concluant, ce qui arrive souvent, et vous verrez plus bas pourquoi c'est normal.
Exemple concret. Votre landing page affiche "Découvrez notre solution de facturation". Vous soupçonnez que ce titre reste trop vague. Vous créez une variante : "Éditez vos factures en 30 secondes, conformes à la réglementation 2026". Deux semaines de test, la moitié du trafic sur chaque version, et le verdict tombe en données plutôt qu'en opinions.
La force de la méthode tient dans la répartition aléatoire : vos deux groupes de visiteurs sont statistiquement identiques (mêmes sources, mêmes appareils, mêmes horaires), la seule différence est la page qu'ils voient. Si les conversions divergent, la cause est identifiable. Le principe des essais cliniques, appliqué à votre site.
A/B test, test multivarié, test A/A : les différences
Trois formats, trois usages :
- A/B test : deux versions, une seule variable modifiée (le titre, le CTA, le formulaire). Le format de référence : le moins gourmand en trafic, les conclusions les plus lisibles.
- Test multivarié (MVT) : plusieurs éléments modifiés simultanément, toutes les combinaisons testées en parallèle (2 titres × 2 visuels × 2 CTA = 8 versions). Chaque combinaison reçoit une fraction du trafic : il faut un volume que seuls les gros sites e-commerce et médias possèdent.
- Test A/A : deux versions identiques l'une contre l'autre. Cela paraît absurde, et c'est pourtant le meilleur moyen de vérifier que votre outil répartit correctement le trafic. Si un test A/A déclare un vainqueur significatif, votre configuration a un problème.
Pour une PME ou une startup : des A/B tests classiques, un A/A si les résultats semblent étranges, et le multivarié attendra que votre trafic se compte en centaines de milliers de visites mensuelles.
Est-ce que ça marche vraiment ? Les chiffres
La question revient en boucle sur les forums de product managers : existe-t-il une preuve que l'A/B testing améliore réellement les résultats ? Réponse honnête en deux temps. Oui, les preuves publiées existent, et elles sont solides. Elles montrent aussi qu'une minorité de tests gagne, ce qu'aucune agence n'aime écrire sur sa page d'accueil.
10 à 25% de tests gagnants : ce que disent les données
Les chiffres publics convergent remarquablement, alors qu'ils viennent d'acteurs différents :
| Source | Échantillon | Tests gagnants (significatifs) |
|---|---|---|
| Optimizely | analyse plateforme | 12% |
| VWO | enquête plateforme | ~14% |
| CXL / Convert | analyse de 28 304 expériences | 20% |
| ConversionTeam (2026) | audit de 2 288 tests, 71 clients | 19,1% |
L'audit ConversionTeam est le plus instructif, parce qu'il publie sa définition et son échantillon : 19,1% des tests produisent un gagnant statistiquement significatif sur la métrique principale, et le taux monte à 25,4% quand on score par groupe de tests (un test et ses itérations comptés ensemble). La fourchette saine pour un programme mature : 10 à 25%. Un prestataire qui vous annonce 70% de tests gagnants mérite une question sur sa définition du mot "gagnant" (et sur ce qu'il fait des tests perdants dans son calcul).
Les géants du web confirment l'ordre de grandeur. Chez Microsoft, un tiers des idées testées améliorent les métriques visées, un tiers n'ont aucun effet mesurable, un tiers les dégradent. Sur Bing, moteur déjà optimisé depuis des années, le taux de succès descend entre 10 et 20% (source : Ron Kohavi, exp-platform.com). Ces équipes disposent de statisticiens à plein temps et de millions d'utilisateurs. Si elles échouent deux fois sur trois, votre taux ne sera pas meilleur. Et c'est précisément pour cela que la méthode vaut de l'or.
Car quand un test gagne, il peut gagner très gros. L'exemple le plus documenté vient de Bing : en 2012, un ingénieur propose de modifier l'affichage des titres d'annonces. L'idée traîne six mois dans le backlog, jugée mineure. Une fois testée, elle génère +12% de revenus, soit plus de 100 millions de dollars par an rien qu'aux États-Unis (source : Kohavi et Thomke, Harvard Business Review, 2017). Personne ne l'avait prédit. L'argument définitif en faveur du test : les humains, experts compris, sont mauvais pour deviner ce qui convertira.
Pourquoi un test perdant est quand même rentable
Reprenez le tiers de tests négatifs mesuré chez Microsoft. Sans A/B testing, ces changements auraient été déployés directement en production, dégradant les conversions sans que personne ne relie la baisse à sa cause. Chaque test perdant est une catastrophe évitée : deux semaines de test payées pour éviter six mois de conversions en berne.
Un test perdant produit aussi de la connaissance réutilisable. Si votre variante "prix affiché dès la page d'accueil" perd nettement, vous venez d'apprendre quelque chose de précieux sur votre audience, à réinjecter dans les tests suivants. Les programmes qui réussissent enchaînent les itérations en capitalisant sur chaque résultat : chez Panja, il a fallu 7 itérations sur la landing page Morphée avant le résultat final. Les six premières versions, isolément, ressemblaient à des échecs. Ensemble, elles formaient un entonnoir vers la bonne réponse.
Le calcul économique est asymétrique : un test coûte quelques jours de travail et deux semaines d'attente, un gagnant rapporte pendant des années. Avec un gagnant sur cinq et des gains qui persistent, la rentabilité se joue sur le volume et la régularité des tests, jamais sur un coup d'éclat isolé.
Quoi tester en priorité (par impact)
Tous les éléments d'une page ne se valent pas. L'audit ConversionTeam a classé 1 272 tests par élément testé ; l'écart entre le haut et le bas du classement atteint 18 points de win rate. Voici les quatre familles à tester, dans l'ordre où nous les priorisons sur nos projets d'optimisation.
Proposition de valeur et headlines
Les tests de copy et de message affichent le meilleur taux de victoire brut : 60% des tests de copy produisent une variante devant le contrôle, et 20% un gagnant statistiquement significatif (ConversionTeam, 40 tests classifiés). Logique : le titre est la première chose lue, et souvent la seule. Un visiteur qui ne comprend pas votre offre en 5 secondes ne descendra jamais jusqu'à votre magnifique section témoignages.
Testez en priorité : la promesse principale (bénéfice concret contre description de fonctionnalités), la spécificité (chiffres, délais, résultats contre adjectifs), et l'alignement avec la source de trafic (le visiteur venu d'une annonce "logiciel de paie" doit lire "paie" dans votre titre, en toutes lettres).
CTA et parcours vers l'action
Le CTA est l'élément le plus testé du marché : environ 3 500 tests recensés dans le benchmark VWO 2026, pour un win rate d'environ 10% (source : VWO Experimentation Benchmark Report 2026). Le volume s'explique par la facilité : changer un libellé de bouton prend dix minutes. Le win rate modeste s'explique par la même raison : tout le monde a déjà cueilli ces fruits, et un libellé pèse rarement autant qu'une proposition de valeur.
Testez au-delà du libellé : la position du CTA (au-dessus de la ligne de flottaison, répété en fin de page), le nombre de CTA concurrents (une page qui propose trois actions n'en obtient souvent aucune), et l'étape suivante (formulaire direct contre prise de rendez-vous, essai gratuit contre démo).
Formulaires et checkout
Les tests de formulaires affichent un win rate plus bas (43,4% brut, 15,8% significatif dans l'audit ConversionTeam), mais les changements structurels demandent plus de tentatives, et les victoires y sont souvent les plus grosses en valeur absolue. Un champ supprimé sur un formulaire de devis peut valoir plus que dix libellés de bouton.
Les suspects habituels : le champ téléphone obligatoire, la création de compte imposée avant l'achat, les frais dévoilés à la dernière étape, et les formulaires qui demandent en 12 champs ce que 3 suffiraient à qualifier. Sur mobile, chaque champ économisé se lit directement dans le taux de complétion. Pour la structure complète d'une page qui convertit, formulaire compris, suivez notre guide de la landing page qui convertit.
Prix, offres et réassurance
La preuve sociale est l'élément le plus testé de l'audit ConversionTeam (215 tests) avec 56,7% de victoires brutes et 18,6% de gagnants significatifs. Position des témoignages, logos clients, notes et avis, garanties : ces éléments répondent à la question silencieuse de tout acheteur ("puis-je leur faire confiance ?"), et leur placement change les résultats autant que leur présence.
Sur les prix et les offres, testez la présentation avant le montant : mensualisation contre paiement annuel, ancrage (l'offre premium qui rend l'offre standard raisonnable), garantie de remboursement mise en avant. Ces tests touchent directement au revenu : encadrez-les d'un suivi de la marge, pour éviter de gagner des conversions en sacrifiant le panier moyen.
Comment lancer un A/B test en 7 étapes
La méthode que nous appliquons sur nos projets CRO tient en 7 étapes, et l'ordre a son importance : les tests qui échouent à prouver quoi que ce soit sautent presque toujours l'étape 2 ou l'étape 3.
1. Choisir la métrique de succès
Une seule métrique principale, définie avant le lancement. Pour une landing page de génération de leads : les formulaires soumis. Pour un e-commerce : les commandes payées (le taux d'ajout au panier reste une métrique secondaire). Le piège classique : regarder dix métriques à la fin du test et déclarer gagnante celle qui a bougé. Avec dix métriques observées, le hasard seul finira par en faire "gagner" une.
2. Formuler l'hypothèse (issue de l'audit, pas de l'intuition)
Une hypothèse solide s'écrit en trois parties : le changement précis, la métrique attendue en hausse, et la raison appuyée sur des données. "Si nous remontons les avis clients au-dessus de la ligne de flottaison, le taux de demande de devis augmentera, parce que les enregistrements de session montrent que 70% des visiteurs quittent la page sans avoir scrollé jusqu'aux avis."
D'où viennent ces données ? D'un audit CRO : analytics, heatmaps, enregistrements de sessions, grille heuristique. L'audit produit une liste priorisée de frictions ; chaque friction devient une hypothèse testable. Tester sans audit, c'est choisir ses hypothèses au doigt mouillé, et le doigt mouillé perd contre les données huit fois sur dix.
3. Calculer la taille d'échantillon nécessaire
L'étape que tout le monde saute, et celle qui invalide le plus de tests. Avant de lancer, un calculateur de taille d'échantillon (Evan Miller, VWO, AB Tasty en proposent gratuitement) vous dit combien de visiteurs chaque variante devra recevoir, à partir de trois entrées : votre taux de conversion actuel, l'amélioration minimale à détecter, et le seuil de confiance (95%).
Ordre de grandeur : pour une page qui convertit à 3%, détecter une amélioration relative de 20% (passer à 3,6%) demande environ 13 900 visiteurs par variante, soit près de 28 000 au total. Si ce chiffre dépasse votre trafic trimestriel, inutile de lancer : la réponse n'arrivera jamais. La section suivante vous dit quoi faire dans ce cas.
4. Créer la variante
Une seule variable modifiée par rapport au contrôle. Si votre variante change le titre, l'image et le formulaire en même temps, un résultat positif ne dira jamais lequel des trois changements a agi. Vérifiez la variante sur mobile, sur les principaux navigateurs, et à vitesse de connexion réelle : une variante plus lente que le contrôle teste votre patience davantage que votre hypothèse.
5. Lancer sur 50/50 et ne pas regarder tous les jours
Répartition égale entre contrôle et variante, tout le trafic de la page concernée, et surtout : cessez de consulter le tableau de bord chaque matin. Cette manie porte un nom, le peeking, et elle fabrique des faux positifs en série. La significativité fluctue pendant un test ; elle peut toucher 95% le mardi et retomber à 80% le jeudi. Arrêter au premier passage au-dessus du seuil transforme une fluctuation en "victoire". Fixez la date de fin à l'avance, à partir du calcul de l'étape 3, et tenez-la.
6. Attendre la significance (95%) ET la durée minimale
Deux conditions cumulatives. La première : atteindre le seuil de confiance de 95% sur la taille d'échantillon calculée. La seconde : couvrir au moins un cycle business complet, soit une semaine entière au minimum, pour lisser les différences entre visiteurs de semaine et de week-end ; deux semaines constituent un défaut raisonnable, et on arrondit toujours à la semaine entière (source : documentation Optimizely). Un test qui atteint 95% en trois jours sur un pic de trafic publicitaire mesure votre campagne du moment, davantage que votre page.
7. Décider : implémenter, itérer ou abandonner
Trois sorties possibles. Implémenter : la variante gagne avec significativité, déployez-la à 100% et documentez le résultat. Itérer : le test est non concluant mais la direction et les enseignements qualitatifs suggèrent une V2 ; la sortie la plus fréquente, et les programmes matures gagnent précisément là (rappel : 19,1% de gagnants par test, 25,4% par groupe de tests avec itérations, dans l'audit ConversionTeam). Abandonner : la variante perd nettement ou l'hypothèse est épuisée ; archivez l'enseignement et passez à l'hypothèse suivante de l'audit. Dans les trois cas, écrivez le résultat quelque part : la mémoire des tests est l'actif le plus sous-coté d'un programme CRO.
Combien de trafic faut-il (et quoi faire si vous ne l'avez pas)
Voici la section que les guides français évitent, parce que sa conclusion fâche : la majorité des sites de PME n'ont pas le trafic pour faire de l'A/B testing dans les règles. Chiffrons.
Les ordres de grandeur : visiteurs et conversions par variante
La taille d'échantillon dépend de deux facteurs : votre taux de conversion de départ et la taille de l'effet à détecter. Plus votre taux est bas et plus l'effet cherché est fin, plus il faut de monde. Les ordres de grandeur, au seuil de confiance de 95% et à puissance statistique standard (80%) :
| Taux de conversion actuel | Amélioration à détecter | Visiteurs par variante | Total du test |
|---|---|---|---|
| 3% | +20% relatif (vers 3,6%) | ~13 900 | ~28 000 |
| 3% | +10% relatif (vers 3,3%) | ~53 000 | ~106 000 |
| 2% | +20% relatif (vers 2,4%) | ~21 000 | ~42 000 |
| 5% | +20% relatif (vers 6%) | ~8 200 | ~16 400 |
Lisez ce tableau avec votre trafic réel en tête. Une page qui reçoit 5 000 visites par mois et convertit à 3% devra tourner presque six mois pour détecter un gain relatif de 20%. Six mois pendant lesquels votre saisonnalité, vos campagnes et votre marché auront changé, contaminant le résultat. Détecter un gain de 10%, plus réaliste pour un test ordinaire, demanderait presque deux ans. Personne ne fait ça.
Notre règle pratique : en dessous d'environ 10 000 visiteurs mensuels et de 200 conversions mensuelles sur la page à tester, l'A/B test classique n'est pas votre meilleur outil. Ce seuil élimine beaucoup de monde. Il ne vous condamne à rien, car il existe une alternative rigoureuse.
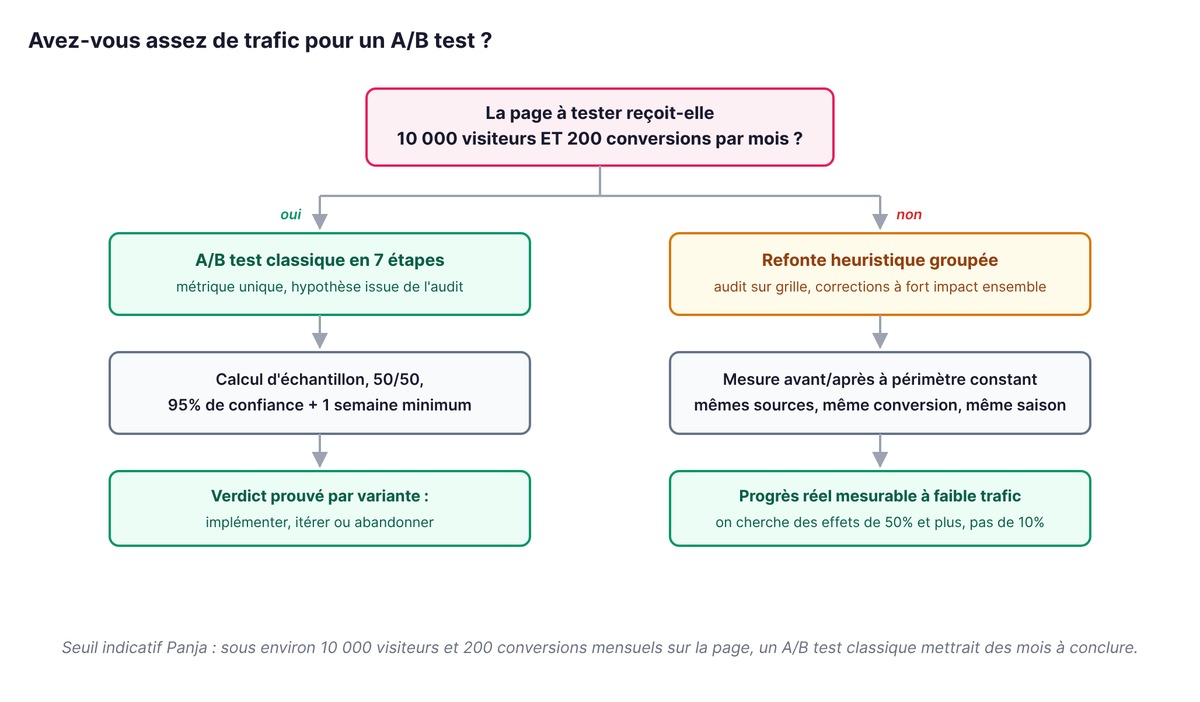
Sous le seuil : refonte heuristique mesurée avant/après (méthode Panja)
Quand le trafic manque, le raisonnement s'inverse : si vous ne pouvez pas détecter des effets de 10%, cherchez des effets de 50% ou plus, en corrigeant plusieurs frictions majeures d'un coup au lieu de les tester une par une.
La méthode que nous appliquons chez Panja sur les sites sous le seuil :
- Audit heuristique complet de la page sur une grille de critères éprouvée : proposition de valeur, alignement avec les annonces, preuve sociale, friction de formulaire, vitesse, mobile. L'audit remplace le test pour identifier quoi changer : les frictions les plus fréquentes sont connues et documentées.
- Refonte groupée : toutes les corrections à fort impact appliquées ensemble sur une nouvelle version de la page.
- Mesure avant/après à périmètre constant : mêmes sources de trafic, même saison si possible, même définition de conversion, sur des périodes comparables.
Vous perdez l'attribution du gain à un élément précis. Vous gagnez la capacité de mesurer un progrès réel avec le trafic dont vous disposez. Le compromis rationnel sous le seuil, et il produit des résultats sans ambiguïté quand les frictions de départ sont grosses : sur Satisfix, startup de réparation à domicile au trafic modeste, la refonte heuristique puis les itérations successives ont fait passer le taux de conversion de 2,5% à 27%. Avec un écart pareil, la question de la significativité ne se pose plus vraiment (aucun hasard ne multiplie vos conversions par dix).
Pour un exemple appliqué, voyez l'A/B testing de landing page dans notre étude de cas sur une marque de vêtements à +344% de nouveaux clients. Pour déléguer ce travail, notre agence landing page applique exactement cette méthode : audit, refonte, mesure, itération.
Les outils d'A/B testing en 2026
Le marché a un absent notable : Google Optimize, l'outil gratuit qui équipait la majorité des petits sites, a fermé le 30 septembre 2023 (source : Google). Depuis, le choix se répartit entre quatre plateformes leaders sur devis et une génération d'outils gratuits ou open source.
AB Tasty, VWO, Optimizely, Kameleoon (et les options gratuites)
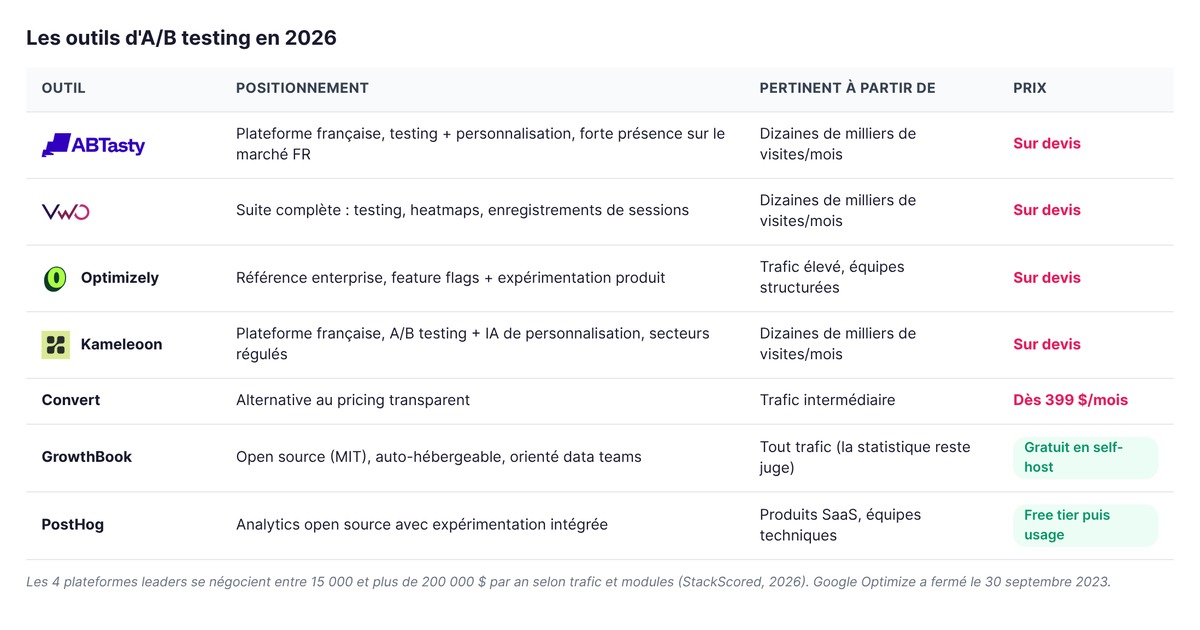
| Outil | Positionnement | Pertinent à partir de | Prix |
|---|---|---|---|
| AB Tasty | Plateforme française, testing + personnalisation, forte présence marché FR | dizaines de milliers de visites/mois | sur devis |
| VWO | Suite complète (testing, heatmaps, enregistrements de sessions) | dizaines de milliers de visites/mois | sur devis |
| Optimizely | Référence enterprise, feature flags + expérimentation produit | trafic élevé, équipes structurées | sur devis |
| Kameleoon | Plateforme française, A/B testing + IA de personnalisation, secteur régulé (banque, santé) | dizaines de milliers de visites/mois | sur devis |
| Convert | Alternative au pricing transparent | trafic intermédiaire | dès 399 $/mois |
| GrowthBook | Open source (MIT), auto-hébergeable gratuitement, orienté data teams | tout trafic (la statistique reste juge) | gratuit en self-host |
| PostHog | Analytics open source avec expérimentation intégrée | produits SaaS, équipes techniques | free tier puis usage |

Sur les prix des quatre leaders, les estimations publiques s'étalent de 15 000 à plus de 200 000 dollars par an selon le trafic et les modules (source : StackScored, 2026). Ce niveau de prix porte un enseignement : ces plateformes se rentabilisent sur des sites où chaque point de conversion vaut des dizaines de milliers d'euros. Pour une PME sous le seuil de trafic vu plus haut, l'abonnement coûterait plus cher que le gain espéré des tests. GrowthBook ou PostHog couvrent le besoin technique pour une fraction du prix, et la vraie dépense se déplace là où elle doit être : l'audit, les hypothèses et la création des variantes.
L'outil ne fait ni la statistique de votre trafic ni la qualité de vos hypothèses. Un compte AB Tasty avec de mauvaises hypothèses produit de beaux rapports sur des tests non concluants.
5 erreurs qui faussent vos tests
Après 40 projets CRO, nous retrouvons les mêmes causes derrière la plupart des tests invalides :
-
Arrêter le test dès que "ça a l'air bon" (peeking). La significativité fluctue en cours de test. Conclure au premier passage au-dessus de 95% revient à lancer une pièce jusqu'à obtenir trois faces de suite, puis déclarer la pièce truquée. Date de fin fixée à l'avance, point.
-
Tester sans calcul d'échantillon. Un test lancé sans savoir combien de visiteurs il exige finit de deux façons : arrêté trop tôt (résultat invalide) ou éternel (résultat jamais rendu). Trois minutes sur un calculateur avant chaque lancement épargnent des semaines de tests fantômes.
-
Modifier le test en cours de route. Changer la variante, la répartition du trafic ou la métrique pendant que le test tourne détruit la comparabilité des groupes. Une envie de modification en cours de test s'écrit dans le backlog et devient le test suivant.
-
Conclure sur une métrique secondaire. Le test visait les demandes de devis, elles n'ont pas bougé, mais "le temps passé sur la page a augmenté de 23%" : voilà comment un test perdu se maquille en victoire dans le reporting. La métrique principale a été choisie à l'étape 1 ; elle seule tranche.
-
Tester pendant une période atypique. Soldes, campagne TV, Black Friday, mois d'août : le comportement des visiteurs y diffère du reste de l'année, et le gagnant d'un test de Black Friday peut perdre en février. Testez sur des semaines représentatives, ou acceptez que le résultat ne vaille que pour ce contexte.
Chacune de ces erreurs produit le même symptôme : un résultat qui ressemble à une preuve sans en être une. Mieux vaut trois tests propres par trimestre que douze tests douteux.
FAQ
Combien de temps dure un A/B test ?
Au minimum une semaine entière pour couvrir un cycle business complet (les visiteurs du week-end se comportent différemment de ceux du mardi), et en pratique deux à quatre semaines pour la plupart des sites. La durée réelle dépend de votre trafic et de la taille d'échantillon calculée avant le lancement : le test se termine quand l'échantillon requis est atteint ET qu'un nombre entier de semaines s'est écoulé, jamais avant.
Peut-on tester plusieurs éléments à la fois ?
Dans un A/B test classique, une seule variable doit changer entre les versions, sinon le résultat n'est pas attribuable. Pour tester plusieurs éléments simultanément, il faut un test multivarié, qui exige un trafic bien supérieur (chaque combinaison reçoit une fraction des visiteurs). L'alternative pour les sites à trafic modeste : regrouper plusieurs corrections dans une refonte mesurée avant/après, en acceptant de perdre l'attribution par élément.
Quel taux de confiance faut-il atteindre ?
Le standard de l'industrie est 95% : il signifie que si la variante n'avait en réalité aucun effet, un résultat aussi marqué n'apparaîtrait que dans 5% des cas par hasard. Descendre à 90% augmente le risque de déployer un faux gagnant ; certains tests à fort enjeu (prix, checkout) justifient au contraire 99%. Le taux de confiance se fixe avant le test et ne se renégocie pas en cours de route.
L'A/B testing est-il utile pour un petit site ?
En dessous d'environ 10 000 visiteurs et 200 conversions par mois sur la page concernée, un A/B test classique mettrait des mois à conclure, et le résultat serait contaminé par la saisonnalité. La méthode adaptée aux petits sites : un audit heuristique pour identifier les frictions majeures, une refonte groupée, puis une mesure avant/après à périmètre constant. C'est ainsi que Satisfix est passé de 2,5% à 27% de conversion malgré un trafic modeste.
L'A/B testing se résume en une phrase : tester beaucoup, conclure rarement, encaisser longtemps.